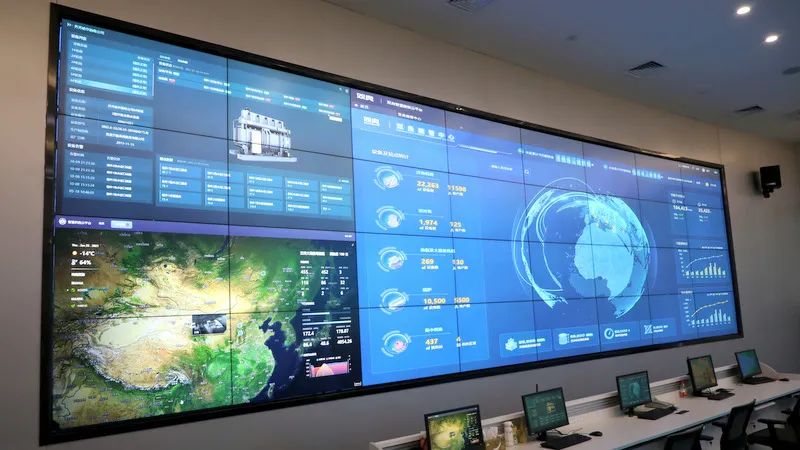
物流大數據處理服務 架構設計與應用實踐
一、物流大數據的特點與處理挑戰
物流行業每天產生海量數據,涵蓋訂單信息、運單軌跡、倉儲進出庫記錄、車輛GPS定位、配送簽收、異常事件等。這些數據具有典型的"5V"特征:數據量大、類型多樣、產生速度快、價值密度低、真實性要求高。傳統的數據處理方式已難以應對日均千萬級運單、億級軌跡點的高并發寫入與實時分析需求,亟需構建專業化的物流大數據處理服務體系。
二、物流大數據處理服務的總體架構
一個完整的物流大數據處理服務通常采用分層架構:
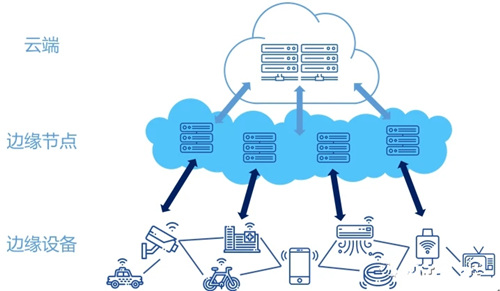
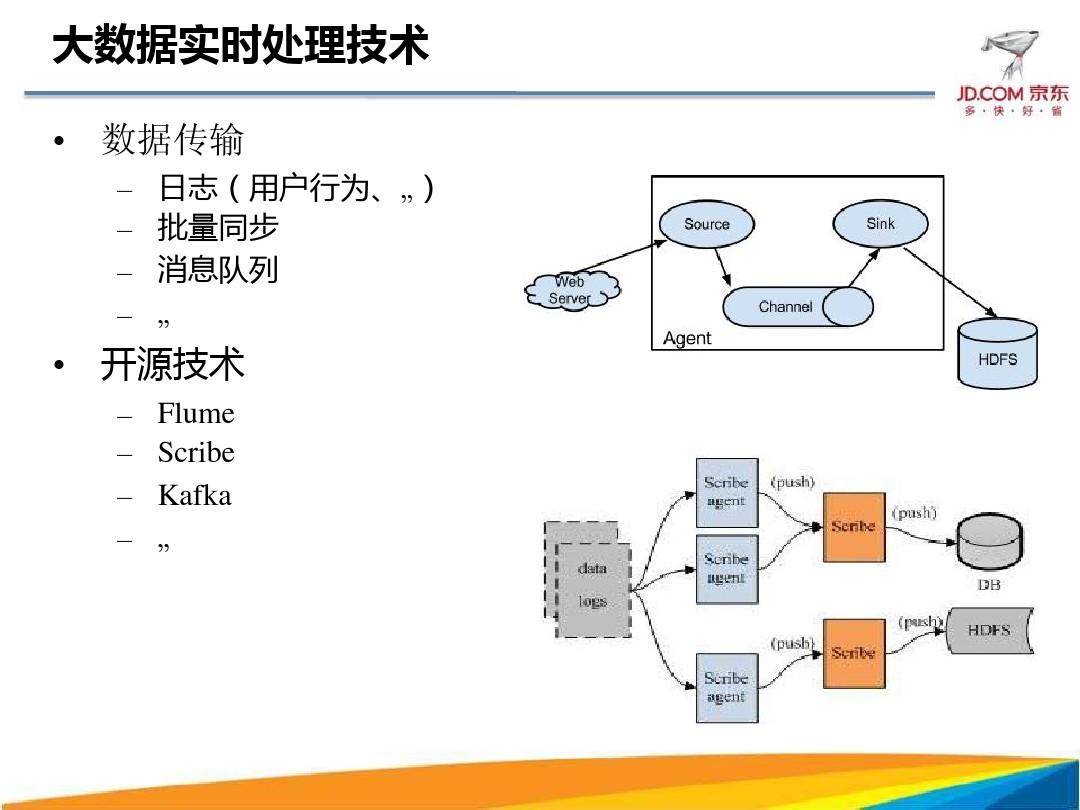
- 數據接入層:負責多源異構數據的統一采集。通過消息隊列(如Kafka)對接業務系統數據庫(CDC變更捕獲)、車載終端、手持PDA、IoT傳感器等,實現實時流數據與批量數據的統一接入。
- 數據存儲層:根據數據熱度采用分級存儲策略。實時軌跡與訂單流數據存入分布式消息隊列與時序數據庫;明細數據落地數據湖(如HDFS或對象存儲);結構化匯總數據存入分布式數據倉庫(如ClickHouse、Doris),支撐高并發查詢。
- 數據計算層:構建批流一體的計算引擎體系。流式計算(如Flink)負責實時軌跡解析、電子圍欄判斷、時效預警;批處理(如Spark)負責歷史數據清洗、路徑還原與指標匯總;即席查詢引擎支撐運營人員的交互式分析。
- 數據服務層:將處理結果封裝為標準API或數據產品,向上層應用(如運輸管理系統、倉儲管理系統、客戶查詢平臺、管理駕駛艙)提供統一的數據服務能力。
- 數據治理與運維層:貫穿全鏈路的數據質量監控、元數據管理、血緣追蹤、權限控制與任務調度,保障數據處理服務的穩定與可信。
三、核心數據服務能力
基于上述架構,物流大數據處理服務通常對外提供以下幾類核心能力:
(1)實時軌跡處理服務:對GPS/北斗定位數據進行實時去噪、抽稀、糾偏與路網匹配,支撐在途可視化與到達時間預測。
(2)訂單全鏈路狀態服務:整合下單、攬收、中轉、派送、簽收各環節事件,構建統一的訂單狀態機,對外提供一致的狀態查詢接口。
(3)時效分析與預警服務:基于歷史時效數據建立分線路、分時段的時效基線,實時識別超時風險并觸發預警。
(4)倉儲作業分析服務:對出入庫、庫內作業、庫存周轉等數據進行聚合計算,輸出庫容利用率、作業效率等指標。
(5)數據開放與訂閱服務:通過API網關與數據訂閱機制,支持下游系統按需獲取數據,避免重復建設。
四、關鍵技術與實施要點
- 數據質量治理:建立字段級校驗規則與異常數據回流機制,對軌跡漂移、時間戳錯亂、重復上報等問題進行自動識別與修復。
- 實時與批量統一:采用Lambda或Kappa架構思路,盡量復用計算邏輯,降低兩套鏈路帶來的口徑不一致風險。
- 資源彈性調度:結合容器化與任務優先級調度,保障大促、旺季等峰值場景下的服務穩定性。
- 安全與合規:對涉及用戶隱私與商業敏感的數據進行脫敏與分級授權,落實數據全生命周期安全管理。
五、應用價值與展望
專業的物流大數據處理服務能夠顯著降低各業務系統的數據重復建設成本,提升數據一致性與實時性,為智能調度、路徑優化、時效承諾、成本核算等上層應用提供堅實的數據底座。隨著湖倉一體、流批融合與AI增強分析技術的成熟,物流大數據處理服務將朝著更實時、更智能、更易用的方向持續演進,成為物流企業數字化運營的核心基礎設施。
如若轉載,請注明出處:http://m.taomeishe.cn/product/51.html
更新時間:2026-11-09 13:02:35